要点
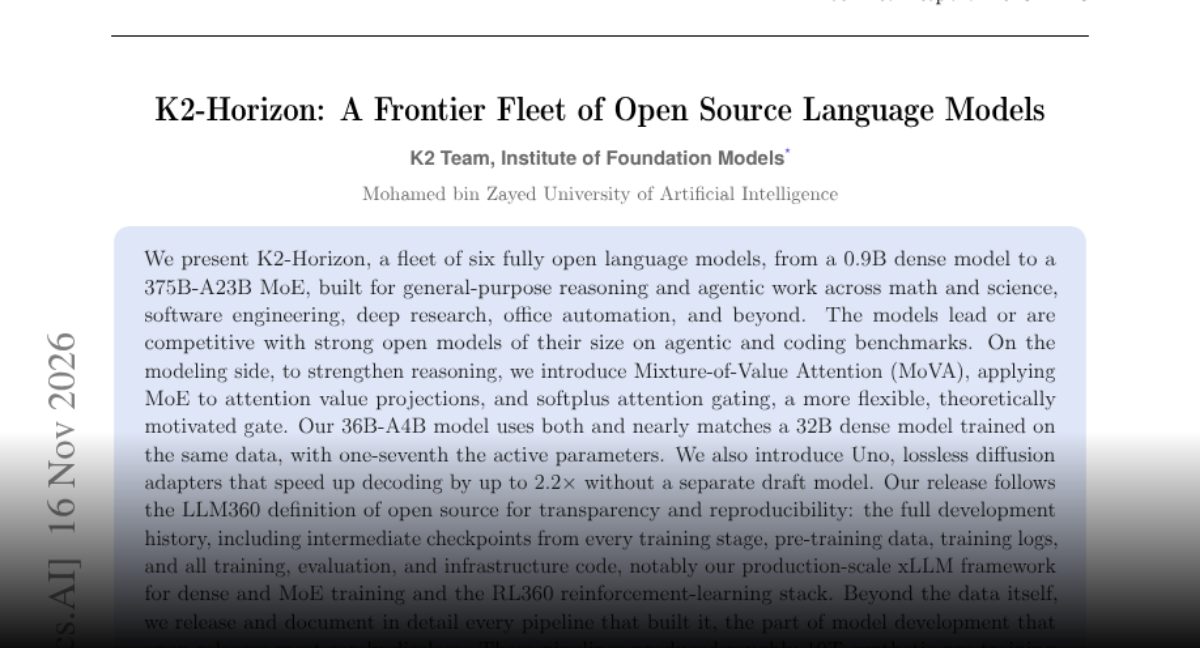
Institute of Foundation ModelsのK2 Teamが、完全にオープンな言語モデル群K2-Horizonを発表した。0.9Bのdenseモデルから375B-A23BのMoEまで6モデルで構成され、著者らの評価ではエージェントやコーディングのベンチマークで同サイズ帯の強いオープンモデルと互角以上とされる。重みだけでなく、各学習段階の中間チェックポイント、事前学習データ、学習ログ、学習・評価・インフラのコードまでをLLM360のオープンソース定義に沿って公開する点が特徴で、約10Tトークンの合成事前学習データを生んだパイプラインも文書化されている。
出典:arxiv.org「K2-Horizon: A Frontier Fleet of Open Source Language Models」
2 :推論が終わりません 2026/11/16(月) 21:40:22.37 ID:XwxeTIZW
また新しいオープンモデルか
最近多すぎて追いきれんのやが
3 :推論が終わりません 2026/11/16(月) 21:43:06.42 ID:0DsJGzE/
ファッ!?
最大 375B が全部タダで公開ンゴか!?
ワイのPCでも最強モデルが動く時代きたンゴ!!
4 :推論が終わりません 2026/11/16(月) 21:44:16.16 ID:ctqjoV8f
>>3 そこ気になるよな、最初はみんなそう思う
375B-A23B は MoE で、実際に動く活性パラメータは 23B の方だぞ
全部公開と手元で軽く動くは別の話なんだよな
5 :推論が終わりません 2026/11/16(月) 21:53:51.03 ID:23Knctqj
モデルは全部で6つあるらしいな
一番小さい 0.9B の dense から最大の MoE まで艦隊みたいに揃えとる
6 :推論が終わりません 2026/11/16(月) 22:01:52.58 ID:iHgh0DsJ
用途は汎用の推論とエージェント仕事を狙っとる
数学や科学、ソフトウェア開発、deep research、office automation まで挙がっとるな
7 :推論が終わりません 2026/11/16(月) 22:13:18.55 ID:7yXwxeTI
事前学習の合成トークンが約 10T って書いてある
合成データが事前学習の主要な材料になっとるのが今どきやな
8 :推論が終わりません 2026/11/16(月) 22:24:09.99 ID:23Knctqj
>>5 4つのモデルは同じ 22T トークンの事前学習コーパスとレシピを共有しとるらしい
規模と疎さの比較がしやすい設計やな
9 :推論が終わりません 2026/11/16(月) 22:29:26.93 ID:0DsJGzE/
モバって何ンゴ
スマホ向けの attention か何かンゴか
10 :推論が終わりません 2026/11/16(月) 22:34:08.07 ID:ctqjoV8f
>>9 MoVA は Mixture-of-Value Attention の略だぞ
attention の value 射影に MoE を入れる工夫で、推論を強くするための仕掛けなんだよな
あと softplus attention gating というゲートも入っとる
11 :推論が終わりません 2026/11/16(月) 22:35:10.55 ID:XwxeTIZW
その2つを両方入れたのが 36B-A4B か
名前の数字がごちゃごちゃしてきたわ
12 :推論が終わりません 2026/11/16(月) 22:37:46.76 ID:ctqjoV8f
K2 Team による評価では、その 36B-A4B が同じデータで学習した 32B dense にほぼ並ぶ性能を出したとある
しかも活性パラメータは7分の1だぞ
13 :推論が終わりません 2026/11/16(月) 22:40:57.96 ID:sJGzE/mv
7分の1で並ぶなら計算代だいぶ浮くやん
これは地味にデカいな
14 :推論が終わりません 2026/11/16(月) 22:45:42.81 ID:iHgh0DsJ
Uno ってのもあるらしいな
デコードを最大 2.2 倍速くするやつ
15 :推論が終わりません 2026/11/16(月) 22:56:25.92 ID:ctqjoV8f
>>14 Uno はドラフトモデルなしで速くする lossless な diffusion アダプタだぞ
速くしても出力の質を落とさない側の工夫なんだよな
16 :推論が終わりません 2026/11/16(月) 23:07:43.17 ID:0DsJGzE/
ウノってトランプのあれしか知らんのやが
AIもカードゲーム始めるンゴか
17 :推論が終わりません 2026/11/16(月) 23:20:35.09 ID:XwxeTIZW
>>16 違う違う、名前が同じだけや
そっちに引っ張られるの定期
18 :推論が終わりません 2026/11/16(月) 23:34:02.90 ID:7yXwxeTI
公開の仕方が LLM360 のオープンソース定義に従っとるってのが売りらしいな
中間チェックポイントまで全部出すとか正気か
19 :推論が終わりません 2026/11/16(月) 23:43:27.19 ID:23Knctqj
学習の各段階の中間チェックポイント、事前学習データ、学習ログ、学習と評価とインフラのコードまで全部だぞ
xLLM という学習フレームワークと RL360 という強化学習スタックも含まれとる
20 :推論が終わりません 2026/11/16(月) 23:53:27.94 ID:ctqjoV8f
要はモデルの重みを配るだけじゃなく、作り方そのものを全部開けるのが K2-Horizon の一番の特徴ってことだぞ
21 :推論が終わりません 2026/11/17(火) 00:02:09.97 ID:nctqjoV8
ワイの職場、未だに去年のモデルで議事録作っとるわ
世界線が違いすぎる
22 :推論が終わりません 2026/11/17(火) 00:09:17.21 ID:iHgh0DsJ
ベンチマークはどうなん
強い強い言われても盛っとるかもしれんやろ
23 :推論が終わりません 2026/11/17(火) 00:20:08.64 ID:ctqjoV8f
>>22 数字の出どころは論文の著者である K2 Team による評価だぞ
エージェントとコーディングのベンチで、同サイズ帯の強いオープンモデルと互角以上かリードと書いてある
第三者の測定が出てくるまでは著者発表として見るのが正解なんだよな
24 :推論が終わりません 2026/11/17(火) 00:29:25.88 ID:0DsJGzE/
じゃあもう GPT とか Claude より強いってことンゴか!?
乗り換えるンゴ!!
25 :推論が終わりません 2026/11/17(火) 00:33:26.56 ID:ctqjoV8f
>>24 記事には書いてないな
書いてあるのは同サイズ帯のオープンモデルとの比較だけだぞ
フロンティア全体と比べた話に勝手に広げない方がいい
26 :推論が終わりません 2026/11/17(火) 00:36:52.38 ID:sJGzE/mv
合成データ 10T って、AIが作った文章でAIを育てる時代なんやな
ぐるぐる回っとる感じするわ
27 :推論が終わりません 2026/11/17(火) 00:43:02.41 ID:7yXwxeTI
その合成データをどう作ったかのパイプラインまで全部文書化して公開しとるらしい
普通のオープン公開が一番明かさない部分だと著者らは言っとる
28 :推論が終わりません 2026/11/17(火) 00:48:37.52 ID:23Knctqj
中間チェックポイントが全部あると、学習のどの段階で何が起きたか後から追える
研究者にはたまらんやつやな
29 :推論が終わりません 2026/11/17(火) 01:01:43.37 ID:XwxeTIZW
ダウンロード容量の話は誰もせんのか
375B とかストレージが死ぬわ
30 :推論が終わりません 2026/11/17(火) 01:14:14.35 ID:iHgh0DsJ
提供元は Institute of Foundation Models で、成果物は ifm.ai/k2 に全部あるらしいな
MBZUAI のチームや
31 :推論が終わりません 2026/11/17(火) 01:16:37.92 ID:0DsJGzE/
はえ〜、サンガツ
とりあえず一番小さい 0.9B ならワイでも触れるンゴね
32 :推論が終わりません 2026/11/17(火) 01:20:34.98 ID:sJGzE/mv
小さい方から大きい方まで同じレシピで揃っとるから、自分の用途に合うサイズを選べるのも艦隊方式の利点やな
33 :推論が終わりません 2026/11/17(火) 01:33:48.07 ID:nctqjoV8
プロ野球のFA市場もこれくらい情報全部開けてくれんかな
年俸の根拠が全然わからん
34 :推論が終わりません 2026/11/17(火) 01:35:36.78 ID:XwxeTIZW
ライセンスの細かい条件はどうなっとるん
35 :推論が終わりません 2026/11/17(火) 01:41:41.11 ID:ctqjoV8f
>>34 論文には LLM360 の定義に従って透明性と再現性を担保するとある
個別のライセンス文面みたいな細部は記事には書いてないな
36 :推論が終わりません 2026/11/17(火) 01:49:20.20 ID:7yXwxeTI
エージェント用途を最初から狙っとるのが最近の流れやな
ただのチャットモデル競争じゃなくなっとる
37 :推論が終わりません 2026/11/17(火) 01:54:15.22 ID:23Knctqj
一番役に立つ見方はこれやな
性能の数字は著者測定として割り引きつつ、公開範囲の広さそのものは事実として評価する
この2つを分けて見るのが大事だぞ
38 :推論が終わりません 2026/11/17(火) 01:59:45.14 ID:iHgh0DsJ
とりあえず小さいやつ触ってみる民が増えそうやな
39 :推論が終わりません 2026/11/17(火) 02:06:45.75 ID:0DsJGzE/
ワイも 0.9B から始めるンゴ
いきなり 375B に手を出して爆死する未来が見えるンゴよ
このスレッドは元記事をもとに運営が作成した架空のものです。書き込みは実在の人物の発言ではありません